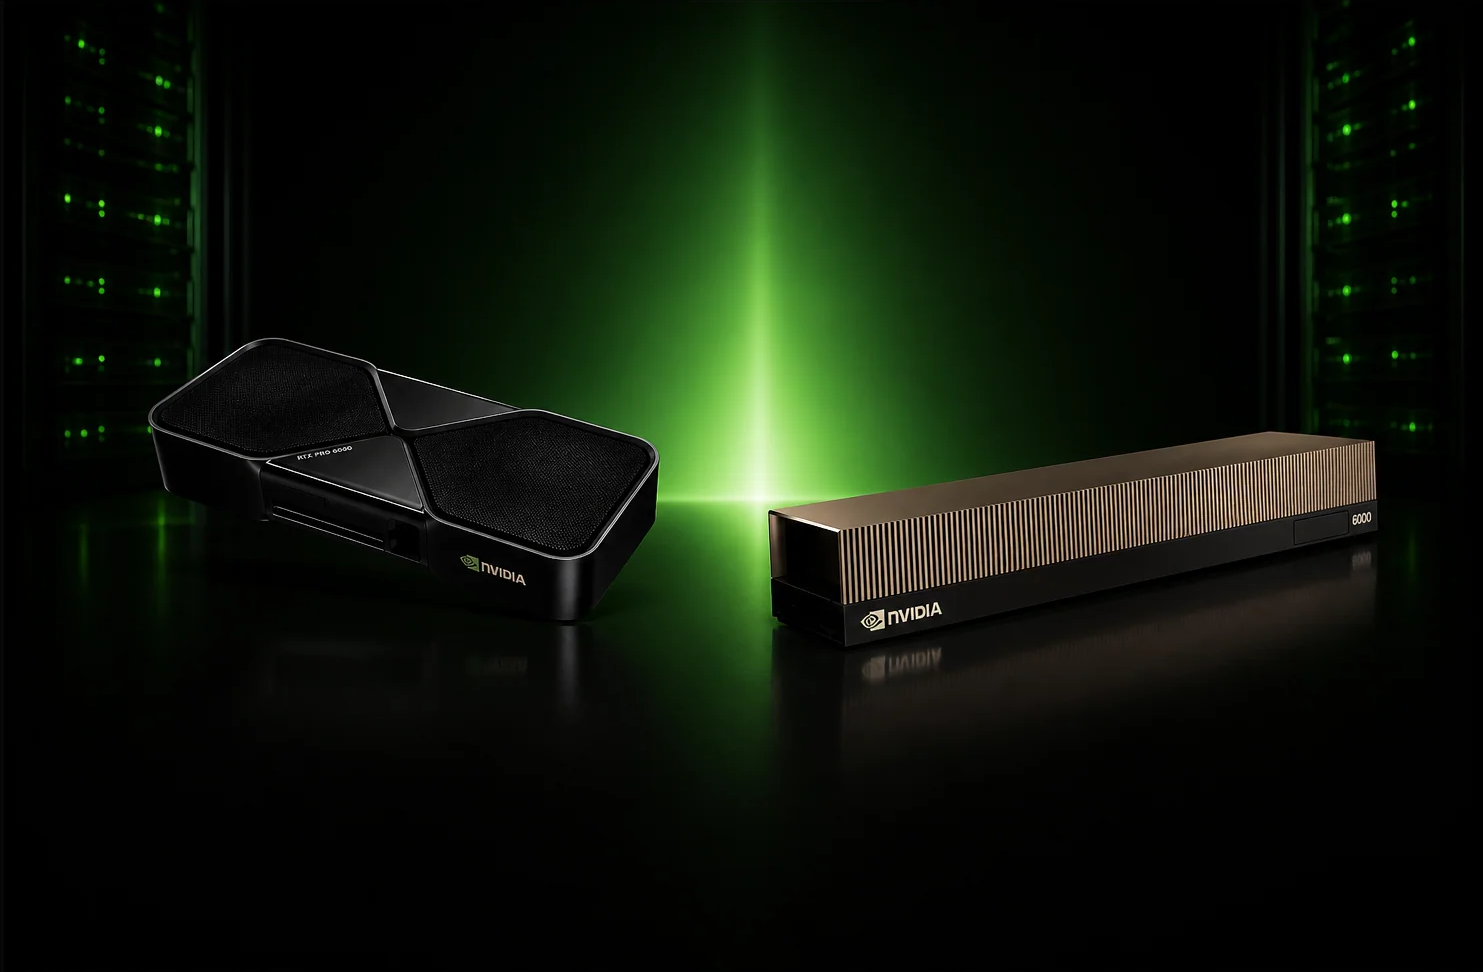
NVIDIA RTX PRO 6000 vs RTX PRO 5000 Blackwell: Сравнение GPU для локального ИИ
Анализ производительности, расчет совокупной стоимости владения (TCO), окупаемости (ROI) и руководство по выбору профессиональных видеокарт нового поколения NVIDIA Blackwell для корпоративных систем инференса и обучения ИИ-моделей.
Сравнение ключевых параметров
| Характеристика | GeForce RTX 5090 (Игровая) | RTX PRO 5000 (48GB) | RTX PRO 5000 (72GB) | RTX PRO 6000 Blackwell |
|---|---|---|---|---|
| Архитектура | Blackwell (TSMC 4N) | Blackwell (TSMC 5nm) | Blackwell (TSMC 5nm) | Blackwell (TSMC 5nm) |
| Объем памяти (VRAM) | 32 GB GDDR7 (Без ECC) | 48 GB GDDR7 ECC | 72 GB GDDR7 ECC | 96 GB GDDR7 ECC |
| Шина памяти | 512-bit | 256-bit | 384-bit | 512-bit |
| Пропускная способность | 1792 ГБ/с | 1344 ГБ/с | 1512 ГБ/с | 1792 ГБ/с |
| CUDA-ядра | 21,760 | 14,080 | ~18,432 | 24,064 |
| Энергопотребление (TDP) | 600 Вт (Пиковое выше) | 300 Вт | 450 Вт | 300 Вт (Max-Q) |
| Режим работы 24/7 | Не сертифицирован (Риск сбоев) | Да (Вычислительный класс) | Да (Вычислительный класс) | Да (Вычислительный класс) |
Соответствие ИИ-моделям на 2026 год
Локальный запуск ИИ требует соответствия объема весов модели доступному объему видеопамяти (VRAM). Ниже приведено распределение моделей по конфигурациям ускорителей:
Сценарии для RTX PRO 6000 / 5000 (72GB)
- • Qwen 3.6 (72B) / Llama 3.3 (70B) в FP16: 2x RTX 6000 (192 ГБ VRAM) запускают модель в чистом качестве без сжатия с огромным контекстным окном.
- • Qwen 3.6 (72B) в INT8: 1x RTX PRO 5000 (72GB) полностью закрывает задачу на одной карте, существенно снижая бюджет.
- • Llama 4 Scout (109B MoE, INT8/FP8): Полностью умещается в VRAM одной карты RTX PRO 6000 (96GB).
Сценарий для GeForce RTX 5090 (32GB)
- • Llama 3.3 70B / Qwen 3.6 72B: Не помещаются в 32 ГБ VRAM. Запуск возможен только с жестким сжатием (2-bit/3-bit), что резко снижает качество ответов, либо с выгрузкой слоев на CPU, что замедляет генерацию до уровня <1-2 токена/сек.
- • Ограничение использования: Карта подходит только для мелких моделей (до 14B/27B) в игровом или тестовом режиме, но неприменима для стабильного корпоративного инференса 70B+ моделей.
Относительная производительность генерации (Llama 3.3 70B / Qwen 3.6 72B)
Мнения пользователей и специалистов
Опыт разработчиков и ИТ-директоров, выбравших готовые профессиональные решения вместо сборки кастомных систем на базе игровых видеокарт.
Data Science Team Lead (EdTech проект)
Опыт: 4x RTX PRO 5000 (72GB) vs 4x GeForce RTX 5090
«Изначально планировали ферму на игровых RTX 5090. Но столкнулись с кошмаром охлаждения: 4 карты требуют 2.4 кВт, перегревают корпус и материнскую плату. Турбинные RTX PRO 5000 72GB работают стабильно, занимают стандартные слоты и легко продуваются в сервере».
ML Ops Engineer (Банковский сектор)
Опыт: Виртуализация ресурсов (vGPU)
«Для корпоративного ИИ игровые карты бесполезны — драйвер RTX 5090 блокирует технологию vGPU. На картах RTX PRO 6000 Blackwell мы нарезаем независимые виртуальные графические профили разработчикам, экономя колоссальные средства на оборудовании».
Lead AI Developer (Стартап голосовых агентов)
Опыт: Сбои и надежность памяти (ECC)
«При круглосуточном инференсе на потребительских картах без ECC происходят случайные перевороты бит, сбивающие контекст LLM. Карты RTX PRO 5000/6000 с аппаратным ECC работают круглосуточно без сбоев».
CTO (FinTech аналитика)
Опыт: Безопасность питания 24/7
«Игровые карты RTX 5090 под постоянной нагрузкой нагревают силовой разъем питания 12V-2x6 вплоть до 150°C. Для бизнеса это колоссальный риск возгорания. Профессиональные RTX PRO созданы для беспрерывной работы под нагрузкой 24/7».
Экономика проекта: Локальный сервер vs Облако
Сравним относительные расходы на аренду GPU-мощностей класса H100 в облаке с приобретением собственного локального сервера на базе видеокарт Blackwell.
| Параметр сравнения | Аренда H100 Cloud | Локальный сервер (Blackwell) |
|---|---|---|
| Первоначальные затраты (CAPEX) | 0% (отсутствуют) | 100% (базовая стоимость оборудования) |
| Аренда / Эксплуатация в год (OPEX) | ~108% от стоимости покупки ежегодно | ~5% от стоимости покупки в год (электричество, хостинг) |
| Окупаемость инвестиций (ROI) | — | ~11 месяцев (менее одного года) |
Финансовые преимущества локального инференса:
При стабильном использовании ИИ-сервисов в компании аренда облачных инстансов H100 формирует постоянный и неконтролируемый OPEX-бюджет. Собственный локальный сервер окупается менее чем за год.
Покупка оборудования в собственность дает ИТ-директору полную предсказуемость бюджетов на годы вперед, независимость от зарубежных провайдеров, отсутствие риска блокировки аккаунтов и гарантирует полную конфиденциальность обрабатываемых коммерческих данных.
Ответы на ключевые технические вопросы
Кроме того, игровые карты из-за огромной толщины (3-4 слота) не приспособлены к плотной установке в серверные корпуса и перегреваются. Профессиональные карты RTX PRO потребляют от 300 Вт до 600 Вт в номинале, но они аппаратно спроектированы и сертифицированы для беспрерывной работы под нагрузкой 24/7. Они выполнены в 2-слотовом Blower-дизайне с выдувом тепла наружу, поддерживают виртуализацию vGPU и коррекцию ошибок памяти (ECC).
Итоги сравнения и рекомендации по выбору
Выбор конкретного графического ускорителя NVIDIA Blackwell зависит от решаемой ИИ-задачи и планируемого бюджета:
RTX PRO 5000 (48GB)
Оптимальный стартовый выбор для работы с моделями малого класса (до 27B параметров, например Qwen 3.8-27B) в полном качестве. Подходит для локальной разработки ИИ-агентов на одном рабочем месте.
RTX PRO 5000 (72GB)
Сбалансированное решение для инференса средних моделей класса 70B–72B (Qwen 3.6 72B / Llama 3.3 70B в INT8). Обладает лучшим показателем окупаемости (ROI) на гигабайт видеопамяти.
RTX PRO 6000 (96GB)
Бескомпромиссный выбор для тяжелого корпоративного инференса, работы с Llama 4 Scout и инференса больших моделей в многопроцессорных узлах. Максимальный задел под длинные контексты.
Не уверены, какое решение выбрать под ваши задачи инференса?
Люди часто не до конца понимают технические параметры ИИ-моделей и требуемый объем видеопамяти. Наш интерактивный помощник поможет вам сориентироваться.
Подобрать решение для ИИ →Запрос на подбор конфигурации GPU
Наши ИИ-инженеры помогут рассчитать конфигурацию сервера или рабочей станции под ваши задачи инференса или обучения моделей.